Visualideas (clone de VisualMind) : un back-end reconstruit en Java et en Python
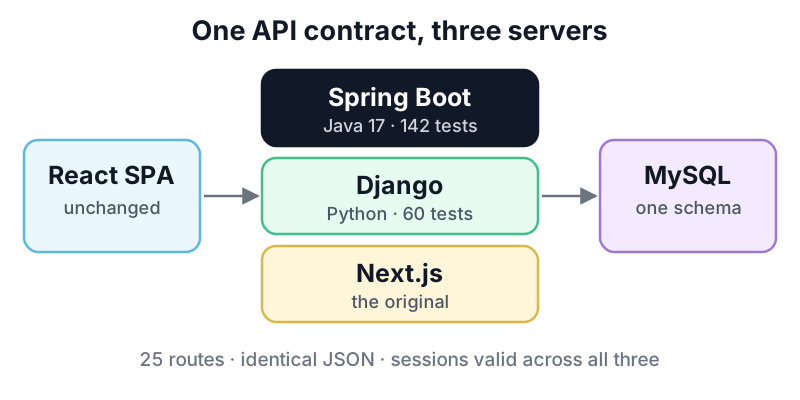
Deux moitiés d’un même système : la SPA React de production que j’ai développée professionnellement — douze routes, un canevas de carte interactif et un client d’API typé qui constitue à lui seul le contrat avec son serveur — et ce serveur reconstruit intégralement en Java et Spring Boot, puis à nouveau en Django. Mêmes chemins, même JSON, mêmes codes de statut : le front-end change de serveur en ne modifiant qu’une variable d’environnement. Puis une troisième passe sur la version Java, cette fois pour la montée en charge : authentification sur les routes qui dépensent de l’argent, limitation de débit par route, plafonds de dépense quotidiens, génération non bloquante, pagination par curseur, et un fichier compose qui lance trois répliques derrière nginx. 169 tests, au vert.
Essayer l’application
Un compte de démonstration partagé sur le produit déployé : connectez-vous et vous y trouverez les douze routes, le canevas de carte et les exports. À noter : visualideas.app tourne sur l’API Node d’origine — c’est donc le front-end que les reconstructions Java et Django devaient satisfaire, et non le serveur Spring lui-même. Le test de remplacement à l’identique décrit plus bas en fait la preuve.
- test@test.app
- Mot de passe
- testuser2026
Résultats
- Routes reconstruites, chemin pour chemin
- 25Routes reconstruites, chemin pour chemin
- Plafonds de montée en charge trouvés et levés
- 9Plafonds de montée en charge trouvés et levés
- Tests Java, tous au vert
- 169Tests Java, tous au vert
- Modification nécessaire côté front-end
- 0Modification nécessaire côté front-end
Chiffres relevés dans les reconstructions elles-mêmes. Les 142 tests du portage Spring et les 60 du portage Django ont été exécutés au vert le 11 août 2026 ; les 169 de la reconstruction pour la montée en charge, le 13 août 2026.
Le front-end au-dessus
Le front-end n’est pas ici une maquette qui tiendrait lieu de vrai client : c’est l’application de production elle-même, celle qui sert visualideas.app — une SPA React 18 et TypeScript construite avec Vite, environ 7 000 lignes réparties sur douze routes, de la page d’accueil, de la connexion et de la réinitialisation du mot de passe jusqu’à l’onboarding, le chatbot, le canevas de carte, l’écran d’export et les réglages. Son cœur est ce canevas, où vis-network dessine un sujet en un graphe à trois niveaux que l’on ouvre branche par branche, que l’on modifie sur place et que l’on déplace à la souris, et où les exports en PNG, PDF, Word, Excel, PowerPoint, OPML, Markdown, texte brut et dans un format .vimap maison sont tous générés dans le navigateur, sans aller-retour serveur. Je développe cette application professionnellement ; dans ce projet, elle occupe un second rôle : celui de l’exigence que les serveurs reconstruits doivent satisfaire.
Tout ce qu’elle demande à un serveur passe par un seul fichier. src/data/api.ts est un client typé — 27 appels sur 21 chemins d’API, couvrant l’authentification, les conversations, les cartes, l’historique, le support, les outils pro et les rapports de bug — et chacun d’eux transite par une unique fonction request(). Cette fonction, c’est le contrat en miniature : elle lit l’URL de base dans une seule variable de compilation, VITE_API_BASE_URL, envoie chaque requête avec credentials: 'include' pour que le cookie de session voyage avec elle, lit le corps en JSON que l’appel ait réussi ou non, et en cas d’échec lève une Error qui porte le message d’erreur du serveur et son code de statut. Changer de serveur revient donc, par construction, à changer une ligne dans un fichier .env — c’est précisément ce qui rendait le test de remplacement possible.
C’est aussi pourquoi les portages ne pouvaient pas se contenter d’être « compatibles ». Le client s’appuie sur le détail : un 402 dont le corps contient subscription_paused redirige toute l’application vers /subscription-paused, tandis que le canevas traite un 401 comme un « connectez-vous pour enregistrer » et laisse cette redirection prendre la main — un code de statut ou un message d’erreur amélioré par un back-end plus soigné se serait donc manifesté comme un bug à l’écran, et non comme une API plus propre. Le canevas est l’appelant le plus exigeant de tous : modifications, déplacements et changements de disposition sont regroupés avec 600 ms de latence en PATCH du document JSON de la carte, et la première modification d’une carte non enregistrée doit la créer exactement une fois — une unique promesse en vol le garantit, puis réécrit l’URL avec le nouvel identifiant pour que le rafraîchissement et le partage continuent de fonctionner. Le moindre écart d’identifiant, de forme du JSON ou de séquencement s’y voit aussitôt, sous forme de carte dupliquée ou de modification perdue. Pointé sur le serveur Java, rien de tel : une variable changée, et l’application a continué comme si de rien n’était.
Dans la reconstruction
Un remplacement, pas une imitation
Un critère de réussite réfutable : on pointe le front-end de production sur le nouveau serveur, on change une variable d’environnement, et rien d’autre ne bouge.
Des sessions valables d’un serveur à l’autre
HS256 figé et mots de passe tronqués aux 72 octets de bcrypt : un cookie émis par l’API Node est accepté en pleine session par celle en Java.
Des erreurs copiées, pas améliorées
Mêmes codes de statut et mêmes messages, jusqu’au 405 nu avec en-tête Allow et au 404 en JSON là où Spring aurait servi du HTML.
142 tests, sans base de données
De vraies requêtes HTTP par MockMvc contre H2 en mémoire, clés d’API figées sur des valeurs factices : la suite ne peut jamais atteindre un service payant.
Deux bibliothèques réécrites
Aucun équivalent Java pour les extracteurs d’articles et de YouTube : un scoreur de lisibilité sous jsoup et un lecteur de sous-titres ont pris leur place.
Puis à nouveau en Django
Un second portage en Python avec ses 60 tests — la preuve que la rigueur tenait à la méthode plutôt qu’à un framework en particulier.
Neuf plafonds, trouvés dans mon propre code
Aucune authentification sur les cinq routes qui dépensent, aucune limitation de débit, un coût enregistré mais jamais appliqué, un fil immobilisé par génération, et LIMIT 200 sans curseur.
Non bloquant, avec une soupape
sendAsync de bout en bout, un sémaphore plafonnant les appels distants en vol, un 503 avec Retry-After au-delà, et des reprises à gigue pour éviter les retours en cadence.
Des limites que le tableau de bord voit
Les plafonds de dépense quotidiens sont mesurés sur la table token_usage qu’exploite déjà le tableau de bord : application et reporting ne peuvent jamais diverger.
Pagination par curseur, microsecondes comprises
Des curseurs plutôt qu’OFFSET — et un curseur tronqué à la milliseconde qui répétait discrètement des lignes d’une page à l’autre, attrapé par deux tests avant quiconque.
Comment ça marche
J’ai travaillé professionnellement sur le front-end de VisualMind : je connais donc cette API de l’extérieur, puisque chaque écran que je construisais l’appelait. Restait à savoir si je pouvais la reconstruire de l’intérieur — un vrai back-end de production, avec des utilisateurs payants, des abonnements et une facture d’IA au bout, pas une application CRUD de tutoriel — en Java, une technologie que je voulais maîtriser réellement et pas seulement connaître.
Je me suis donc fixé une règle qui rendait le résultat mesurable plutôt qu’affaire d’appréciation : le serveur final devait être un remplacement direct. On pointe le front-end de production dessus, on ne change que l’URL de l’API, et tous les écrans doivent continuer de fonctionner. C’est bien plus exigeant que « réimplémenter les fonctionnalités » : 25 modules de routes aux mêmes chemins et méthodes, des corps de requête lus de la même façon, un JSON de réponse identique clé pour clé, les mêmes codes HTTP et les mêmes messages d’erreur — le front-end teste certains de ces textes, donc une meilleure formulation aurait été un bug. Même les recoins devaient survivre : un fichier de route Next.js qui n’exporte que POST répond à un GET par un 405 nu avec un en-tête Allow — la version Spring fait de même — et un chemin /api/ inconnu renvoie un 404 en JSON plutôt que la page d’erreur HTML par défaut de Spring.
Le plus difficile n’était pas les routes, mais la session de connexion. Les deux serveurs devaient émettre et accepter le même cookie, et deux détails refusaient discrètement de s’aligner. jjwt choisit l’algorithme le plus fort que la longueur de la clé autorise : un secret de 64 octets produisait donc silencieusement du HS512, là où le jsonwebtoken de Node émet toujours du HS256 — j’ai figé l’algorithme. Et bcrypt ne lit jamais que les 72 premiers octets d’un mot de passe : bcryptjs tronque en silence quand Spring Security lève une exception, la troncature est donc faite à la main avant le hachage. Les deux points sont couverts par des tests, et le résultat est ce que je préfère dans ce projet : on peut se connecter sur le serveur Node et voir le serveur Java accepter le cookie, en pleine session, sans nouvelle authentification.
Derrière les routes : 13 contrôleurs, 9 services et 11 entités JPA posées sur les 11 tables déjà existantes. La gestion du schéma par Hibernate est entièrement désactivée — il ne peut donc jamais créer, modifier ni valider une table qu’il n’a pas écrite, puisque ce serveur a vocation à être branché sur une base que l’application en ligne a déjà remplie. C’est dans les services que vit le produit : authentification JWT et BCrypt, un garde qui répond 402 lorsqu’un administrateur a suspendu un abonnement remboursé, une comptabilité du coût OpenAI appel par appel tarifée par modèle, la création et l’activation d’abonnements PayPal, et un envoi SMTP qui bascule sur la console en développement. Deux paquets npm n’avaient pas d’équivalent Java digne de confiance : je les ai écrits — l’extraction d’articles est devenue un scoreur de lisibilité sous jsoup qui classe les blocs par densité de texte, et les transcriptions YouTube un lecteur maison des documents de sous-titres qui se cachent derrière la page de lecture.
La confiance vient des tests — 142, qui font passer de vraies requêtes HTTP par MockMvc contre une base en mémoire : toute la suite tourne sur un portable, sans MySQL et sans réseau. La clé OpenAI est figée sur une valeur factice évidente dans la classe de base, et les propriétés de test de Spring l’emportent sur les vraies variables d’environnement : la suite ne peut donc rien dépenser, même sur une machine où de vraies clés sont exportées. Face à la base de production, le portage tient aussi : les 11 tables et chaque colonne mappée sont bien là, un hachage écrit par le seeder Node s’authentifie en Java, et un jeton émis en Java se vérifie avec le vérificateur de Node. Puis j’ai tout refait en Django, avec ses 60 tests, pour vérifier que ce qui se transposait était la méthode — et pas ma chance avec un seul framework.
Réussir le test de remplacement prouvait que le portage était correct. Cela ne prouvait pas qu’il tiendrait le trafic — et le relire avec cette question en tête a fait apparaître neuf choses qui le plafonnaient. Cinq routes qui dépensent réellement de l’argent sur le compte OpenAI n’avaient aucune authentification : un abonnement suspendu était refusé, mais un appelant anonyme passait sans encombre — et il n’y avait aucune limitation de débit nulle part. Le coût de chaque appel était soigneusement écrit dans une table que rien ne relisait jamais : la comptabilité était un rapport, pas une limite. Chaque génération immobilisait un fil de requête Tomcat pendant tout l’appel distant, jusqu’à deux minutes : 200 générations simultanées formaient donc le plafond dur, et un OpenAI lent affamait de fils les connexions et les sondes de santé. Chaque liste était un LIMIT 200 nu, sans curseur : la 201e carte d’un utilisateur était inatteignable par toute requête que le front-end savait faire. Et chaque requête authentifiée relisait la ligne de l’utilisateur dans MySQL.
J’ai corrigé les neuf dans une copie, en laissant intacte la version qui marchait, pour que les deux tournent côte à côte sur la même base. La génération est désormais non bloquante de bout en bout : le fil de requête valide, autorise, puis se rend, l’appel distant part sur HttpClient.sendAsync, et un sémaphore plafonne le nombre d’appels en vol — le serveur déleste avec un 503 et un Retry-After plutôt que d’empiler une file qui expirera de toute façon. Les reprises utilisent un délai exponentiel avec gigue : sans gigue, tout ce qui a été limité au même instant réessaie en cadence et recrée le pic qu’on cherchait à éviter. Les limites de débit sont par route et par identité, lues dans le JWT pour qu’une requête sur le point d’être rejetée ne touche jamais la base, et déplacées dans un script Lua Redis dès qu’il y a plus d’une instance — des compteurs en mémoire donneraient à chaque utilisateur N fois son quota sur N répliques. Les plafonds de dépense quotidiens sont mesurés sur la table token_usage que le tableau de bord d’administration exploite déjà, si bien qu’application et reporting ne peuvent pas diverger, et GET /api/auth/usage indique ce qu’il reste — une limite que l’utilisateur ne voit pas est une limite qu’il vit comme une panne aléatoire.
Le chemin de lecture a changé lui aussi. Les listes sont passées à des curseurs plutôt qu’à des décalages : LIMIT 200 OFFSET 10000 oblige MySQL à parcourir puis jeter dix mille lignes, et des lignes qui bougent entre deux requêtes font apparaître des éléments deux fois ou pas du tout ; l’identifiant fait partie de la clé de tri, parce que updated_at n’est pas unique. La requête de la barre latérale utilise maintenant des projections qui laissent les blocs JSON des cartes dans la base au lieu de charger 200 documents entiers pour afficher une liste de titres et de dates. La conversation peut être diffusée en SSE, les images générées sont écrites dans un magasin et servies par URL sous un cache immuable d’un an au lieu d’être incluses en base64 de plusieurs mégaoctets, et la ligne de l’utilisateur est mise en cache quinze secondes, chaque écriture l’invalidant — le cache est un instantané, et les routes qui modifient l’utilisateur relisent la ligne vivante, car passer une entité détachée et périmée à save() est précisément la façon dont naissent les écrasements silencieux.
Le reste est ce qui rend le tout exploitable, et pas seulement rapide : des métriques Prometheus et des sondes de santé sur leur propre port, un identifiant de requête estampillé sur chaque ligne de log — un seul grep restitue tout ce qu’une requête défaillante a fait —, un arrêt en douceur pour qu’un déploiement progressif ne tue pas des générations déjà payées, une vérification au démarrage qui refuse de booter en production sur un secret JWT faible ou un cookie non sécurisé, et un fichier compose qui lève trois répliques derrière nginx avec Redis pour les compteurs partagés — le moyen le moins cher de découvrir si quelque chose dépendait silencieusement d’être l’unique instance. 169 tests, au vert. Deux d’entre eux ont attrapé un vrai bug dans mon propre encodage de curseur : j’avais encodé l’horodatage en millisecondes alors que MySQL garde les microsecondes, si bien que chaque ligne située dans la milliseconde tronquée se comparait comme « après le curseur » et revenait aussi à la page suivante. J’ai également écrit le webhook PayPal, vérifié et idempotent, puis je l’ai livré désactivé par défaut : l’application d’onboarding est déjà abonnée à ces événements, et l’activer traiterait chaque renouvellement deux fois.
Architecture
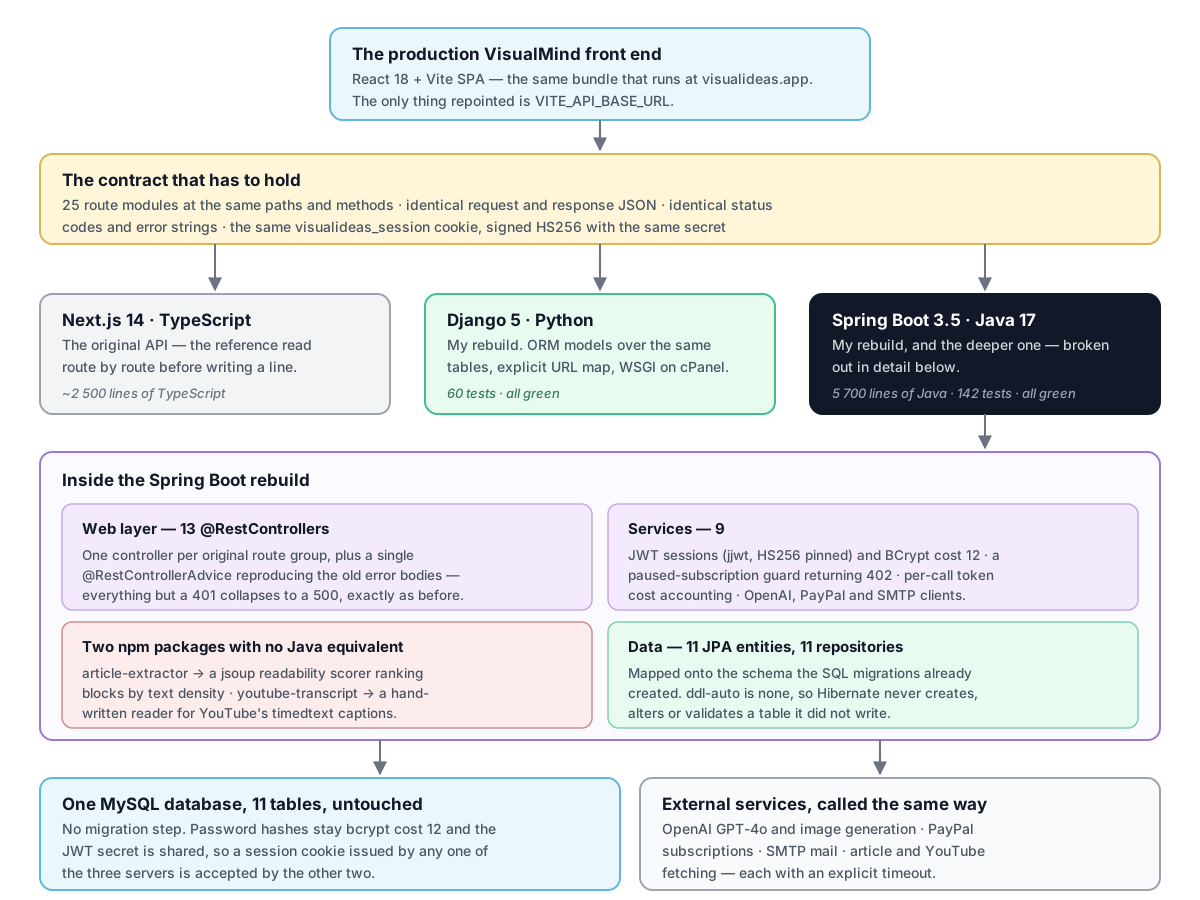
Un front-end, un contrat, trois serveurs qui l’honorent — et de quoi est fait celui en Java. Cliquer sur le schéma pour l’ouvrir en taille réelle.